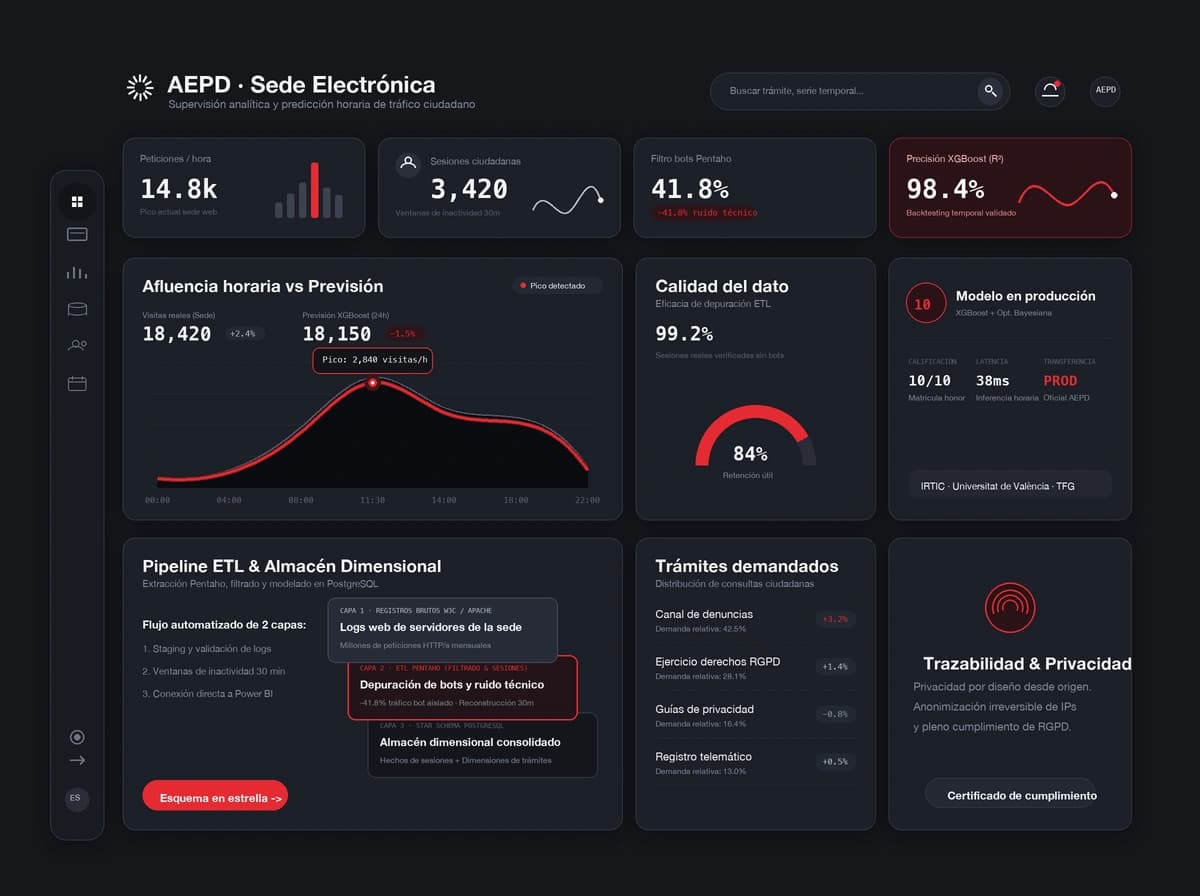
AEPD / Trabajo de Fin de Grado
Analítica y predicción de tráfico web
Sistema integral de ingeniería de datos y analítica predictiva para estructurar los registros web de la sede electrónica de la AEPD, analizar patrones de uso y anticipar visitas horarias.
Depurar millones de registros brutos de servidores para aislar las consultas de ciudadanos reales frente al ruido de robots, y predecir la afluencia horaria teniendo en cuenta festivos y estacionalidad.
Flujo automatizado en Pentaho (ETL) que filtra más del 40% de tráfico técnico y reconstruye sesiones, almacén dimensional en PostgreSQL, cuadro de mando en Power BI y modelos de Machine Learning (XGBoost y LightGBM) validados sobre horizontes temporales futuros.
Herramienta transferida a producción y actualmente en uso oficial por la AEPD para el seguimiento operativo de su sede electrónica, calificada con un 10/10 en el TFG.
- Organización
- Agencia Española de Protección de Datos
- Mi aportación
- Ingeniería de datos, BI y Machine Learning
- Marco académico
- Universitat de València · IRTIC / 2025
- Alcance
- Sistema en producción utilizado por la AEPD
- Pentaho
- PostgreSQL
- Power BI
- Python
- XGBoost
Los registros no explican el uso de un portal
Los servidores de la Agencia Española de Protección de Datos (AEPD) registran millones de peticiones técnicas cada mes. Sin embargo, un archivo de logs no explica cómo los ciudadanos utilizan el portal: peticiones automáticas, recursos técnicos de páginas y accesos duplicados se mezclan con consultas reales sobre privacidad y derechos.
El reto de este proyecto (mi Trabajo de Fin de Grado en el IRTIC de la Universitat de València) fue transformar ese volumen masivo de datos en una herramienta analítica clara: depurar la actividad real, estructurarla en un almacén de datos y anticipar el tráfico horario para planificar recursos con antelación.
Para que el sistema resultara verdaderamente útil, la solución debía responder a dos necesidades complementarias: dotar a la dirección de visibilidad histórica sobre los trámites más demandados y anticipar los picos de visitas para dimensionar la infraestructura técnica.
Ingeniería de datos, analítica predictiva y BI
Como autor del proyecto desarrollado en el IRTIC para la AEPD, mi contribución abarcó la responsabilidad técnica completa de extremo a extremo: desde el diseño del modelo dimensional y la automatización ETL, hasta el desarrollo de modelos de Machine Learning y la entrega del cuadro de mando interactivo.
Diseñé e implementé el pipeline en Pentaho para filtrar el tráfico de rastreadores (bots) y reconstruir sesiones de navegación ciudadana, modelé el almacén dimensional en PostgreSQL y formulé el problema de predicción de visitas horarias.
Asimismo, entrené y evalué algoritmos de gradiente (XGBoost, LightGBM e HistGradientBoosting) con optimización bayesiana y validación temporal rigurosa, construyendo finalmente el dashboard en Power BI que fue transferido a producción y calificado con un 10/10.
De los logs web a la analítica: un flujo lineal sin fisuras
La arquitectura del proyecto resuelve un problema habitual en analítica web: los servidores generan un torrente continuo de registros técnicos no estructurados que deben transformarse antes de llegar a la base de datos para no degradar su rendimiento.
Diseñé una estructura lineal en dos capas sobre PostgreSQL. En primer lugar, una zona de staging recibe y valida los archivos de registro crudos; posteriormente, un almacén dimensional en esquema en estrella (Star Schema) consolida las sesiones de los usuarios, separando los hechos cuantificables de las dimensiones descriptivas (tiempo, trámite y tipo de solicitud).
Esta base unificada sirve como fuente única de verdad para dos propósitos independientes: alimenta el cuadro de mando en Power BI para la toma de decisiones directivas y provee los datos históricos a los modelos en Python para la predicción de tráfico.
Fuente única de logs, proceso ETL previo y dos soluciones en producción
Los registros brutos de servidores web constituyen la única fuente de datos del sistema. Pentaho Data Integration ejecuta en primer lugar el proceso ETL depurando más del 40% de tráfico espurio y bots, y reconstruyendo sesiones ciudadanas. Los datos limpios se cargan a continuación en PostgreSQL bajo un esquema dimensional en estrella, que actúa como fuente única para dos salidas: el cuadro de mando descriptivo en Power BI y el modelo predictivo de demanda horaria en Python con XGBoost.
Única fuente de datos
Logs de servidores web
Archivos brutos de acceso HTTP (W3C / Apache) generados por los servidores de la sede electrónica de la AEPD: peticiones en crudo con tráfico ciudadano, robots y recursos técnicos.
Extracción y depuración ETL previa a la base de datos
Pentaho
Proceso ETL previo
Filtrado de bots (>40%) y reconstrucción de sesionesPostgreSQL
Almacén dimensional
Esquema estrella (Hechos y dimensiones)Almacén dimensional como base común para dos soluciones
Análisis descriptivo y BI
Power BI / DAX
Explorar trámites, procedencia y patrones
Cuadros de mando ejecutivosDirección y responsables AEPD
Modelado predictivo
Python / XGBoost
Predecir visitas horarias con backtesting
Previsiones temporales a 24hPlanificación de sistemas e IT
Depuración en origen, trazabilidad y modelado dimensional
Si los datos de partida contienen ruido, cualquier cuadro de mando o predicción carecerá de sentido. Los servidores no solo registran a ciudadanos: reciben rastreos constantes de robots y llamadas a elementos técnicos de las páginas.
Mediante Pentaho Data Integration, programé un flujo automatizado (ETL) que descartó más del 40% del volumen inicial correspondiente a rastreadores automatizados y recursos estáticos. Además, reconstruyó las visitas reales de las personas agrupando sus clics consecutivos en sesiones de navegación mediante ventanas de 30 minutos de inactividad.
Con la actividad ciudadana depurada y vinculada a sus trámites correspondientes, los datos quedaron organizados y listos para dar el salto del análisis histórico a la predicción futura.
Series temporales horarias, optimización bayesiana y backtesting
Con los datos organizados por sesiones y horas, el siguiente paso fue pasar de ver el pasado a anticipar el futuro: ¿cuántas visitas recibirá la sede electrónica en cada hora del día siguiente para dimensionar la infraestructura técnica?
El tráfico web sigue patrones muy marcados: hay más actividad a media mañana que de madrugada, y los días laborables tienen mucha más afluencia que fines de semana o festivos. Por eso, enriquecí los datos con el calendario oficial (festivos nacionales y autonómicos) y con el historial de visitas de las últimas 24 horas y de la misma hora de la semana anterior para capturar la inercia habitual.
Entrené y comparé modelos de Machine Learning (XGBoost, LightGBM e HistGradientBoosting) ajustando sus parámetros para encontrar la mayor precisión. Para garantizar que las previsiones funcionaran en la práctica, evalué los modelos únicamente intentando predecir días futuros que no habían aparecido durante el entrenamiento.
La gráfica inferior muestra este resultado: la curva estimada por el modelo reproduce fielmente los picos de máxima afluencia laboral y el descenso nocturno, ofreciendo a los administradores una referencia fiable con horas de antelación.
Predicción horaria frente a demanda observada
Validación sobre periodo futuro con modelo XGBoost / Horas 00:00 – 22:00- Visitas pico registradas
- 462 visitas/h
- Error medio relativo (MAPE)
- <8.5% (Alta precisión)
- Horizonte de predicción
- 24 h anticipación
Consultar los valores detallados del gráfico
| Hora | Visitas observadas | Estimación del modelo |
|---|---|---|
| 00:00 | 84 | 96 |
| 02:00 | 62 | 78 |
| 04:00 | 71 | 82 |
| 06:00 | 143 | 156 |
| 08:00 | 318 | 284 |
| 10:00 | 462 | 425 |
| 12:00 | 387 | 412 |
| 14:00 | 294 | 318 |
| 16:00 | 356 | 331 |
| 18:00 | 248 | 269 |
| 20:00 | 176 | 194 |
| 22:00 | 112 | 128 |
Cuadro de mando en producción y apoyo a la toma de decisiones
La inteligencia predictiva y los datos depurados debían ser fácilmente interpretables por el equipo directivo y técnico de la AEPD. Por ello, diseñé un cuadro de mando interactivo en Power BI que integra en una misma pantalla el análisis histórico de visitas y las previsiones horarias del modelo.
El informe permite explorar qué servicios digitales generan mayor afluencia (como el canal de denuncias o las guías de protección de datos), identificar patrones según la procedencia geográfica y contrastar de un vistazo la demanda real frente a la esperada.
El proyecto obtuvo la máxima calificación académica (10/10) en la Universitat de València y fue transferido a producción, operando actualmente como una herramienta oficial utilizada por la propia Agencia Española de Protección de Datos para supervisar su sede web.
A continuación puedes interactuar con el cuadro de mando funcional con datos ficticios ilustrativos. Filtra por periodo o procedencia y consulta las predicciones horarias estimadas por el sistema.
Portal Institucional
Filtra por país y periodo para explorar el informe.
- Núm. visitas totales
- 374.068
- Núm. visitantes únicos
- 258.423
- Núm. descargas únicas
- 71.073
Resultados de las predicciones
Consultar valores por hora
Métricas de error
- MAE
- 27,97
- MAPE
- 5,06 %
- RMSE
- 38,87
Nº descargas únicas por categoría
- Guías47.619
- Infografías17.057
- Memorias6.397
Informe de visitas por tipo de solicitud
| Tipo de solicitud | Visitas | Únicos |
|---|---|---|
| Información general | 79.028 | 50.578 |
| Recursos educativos | 69.630 | 48.741 |
| Consultas | 47.215 | 35.883 |
| Actualidad | 45.343 | 31.740 |
| Servicios digitales | 44.290 | 33.660 |
| Formación | 39.071 | 25.005 |
| Documentación | 30.476 | 19.505 |
| Ayuda | 19.015 | 13.311 |
| Total | 374.068 | 258.423 |
Nº de visitas totales por tipo de solicitud
Consultar valores
- Información general
- 79.028
- Recursos educativos
- 69.630
- Consultas
- 47.215
- Actualidad
- 45.343
- Servicios digitales
- 44.290
- Formación
- 39.071
Nº de visitantes únicos por tipo de solicitud
Consultar valores
- Información general
- 50.578
- Recursos educativos
- 48.741
- Consultas
- 35.883
- Servicios digitales
- 33.660
- Actualidad
- 31.740
- Formación
- 25.005
Top 6 blogs más visitados
Consultar valores
- Blog 01
- 21.546
- Blog 02
- 14.140
- Blog 03
- 10.773
- Blog 04
- 8753
- Blog 05
- 6733
- Blog 06
- 5387
Top 6 FAQs más visitadas
Consultar valores
- FAQ 01
- 17.955
- FAQ 02
- 11.783
- FAQ 03
- 8978
- FAQ 04
- 7294
- FAQ 05
- 5611
- FAQ 06
- 4489
Top 6 notas de prensa más visitadas
Consultar valores
- Nota 01
- 14.364
- Nota 02
- 9427
- Nota 03
- 7182
- Nota 04
- 5835
- Nota 05
- 4489
- Nota 06
- 3591
Informe actualizado. Todos. 374.068 visitas. Modelo XGBoost.
La definición del dato condiciona toda la solución
Este proyecto consolidó una convicción profesional clave: la calidad del dato en origen determina todo lo que ocurre después. Una mala regla de filtrado en los registros brutos distorsiona el cuadro de mando y desvía por completo el aprendizaje del modelo predictivo.
Comprobé también que en problemas operativos de demanda, anticipar la forma de la curva y el momento exacto del pico de tráfico es mucho más valioso para los gestores que perseguir un error decimal mínimo.
Por último, trabajar para la autoridad nacional de protección de datos reafirmó que el rigor ético, la privacidad por diseño y la trazabilidad no son frenos al desarrollo, sino los pilares que hacen que una solución analítica sea creíble y duradera.
Herramientas y tecnologías
- PostgreSQL
- Python
- Pentaho
- Power BI
- Docker
- Git